

Un preset fotográfico como workflow de ComfyUI, con la medición a la vista
Prueba propia de portfolio, no un trabajo de cliente. 7 fotos reales con licencia CC0 (Wikimedia Commons). El preset mejora fotos existentes: no genera caras, manos ni objetos. Estimaciones marcadas como tales.
El problema
Una app de edición de fotos que ya funciona en producción tiene el pipeline en Python: preprocesar y escalar, mejorar con IA (por ejemplo corregir una foto sobreexpuesta), gradación con LUTs y escalado final. Quiere pasarlo a ComfyUI ejecutado por API, con cada preset de un fotógrafo como un workflow y el backend orquestando. Y con una regla estricta: es mejora de fotos reales, no generación; se tienen que conservar la identidad, la textura de la piel y los detalles de la escena, sin caras, manos ni objetos inventados.
Qué hicimos
- Un preset = un JSON de workflow, lanzado por un cliente Python sobre la API de ComfyUI (
/prompt, websocket,/history): registra segundos por nodo y etapa, pico de VRAM y coste por foto. Versiones fijadas (ComfyUI 0.37.0, hashes de modelos). - Nodos propios en Python: refinado de recorte con filtro guiado, recuperación de exposición por regiones (separa base y detalle y deja el detalle intacto), nodo de LUT .cube con máscaras por región (el «porta tu gradación a nodos») y escalado x2 con anclaje de bajas frecuencias.
- Modelos con licencia comprobada: BiRefNet (MIT) para el recorte y 2xNomosUni SPAN (CC BY 4.0) para el escalado. Descartamos lo que no pudimos verificar (por ejemplo, los pesos de RealESRGAN no declaran licencia propia).
- Una versión clásica sin IA (auto-niveles + la misma LUT + Lanczos) para compararla foto a foto, y una evaluación sobre un set fijo con hojas lado a lado, métricas de fidelidad y mapas de «dónde cambió la estructura».
Ejemplos: original, clásico sin IA, preset
Tres de las 7 fotos, las que no tienen personas. Las hojas completas, los recortes a 2x y los mapas de cambio están en el repositorio. Qué se ve es lectura nuestra: el preset es más conservador y más plano que el clásico, que suele ser más «punchy».
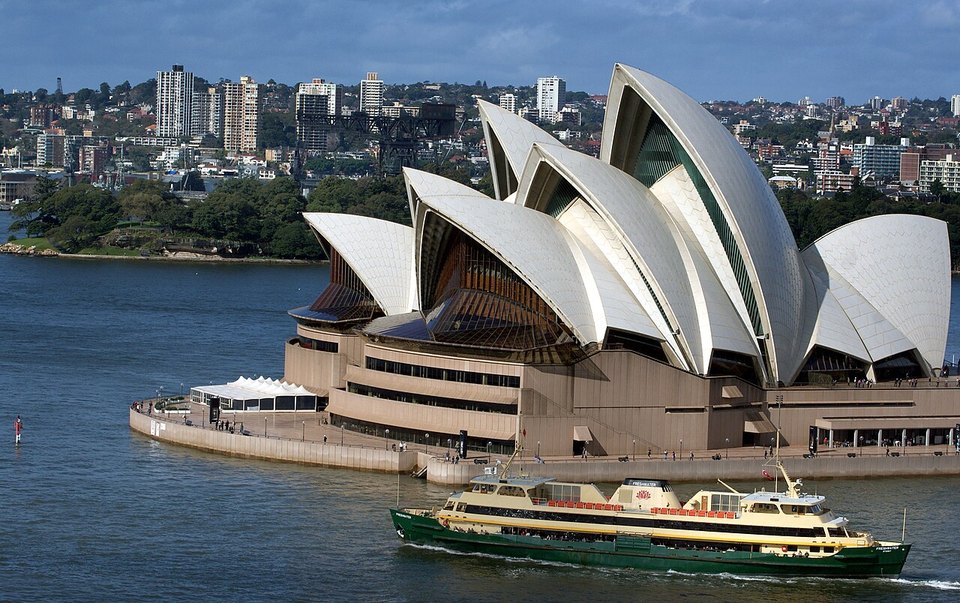
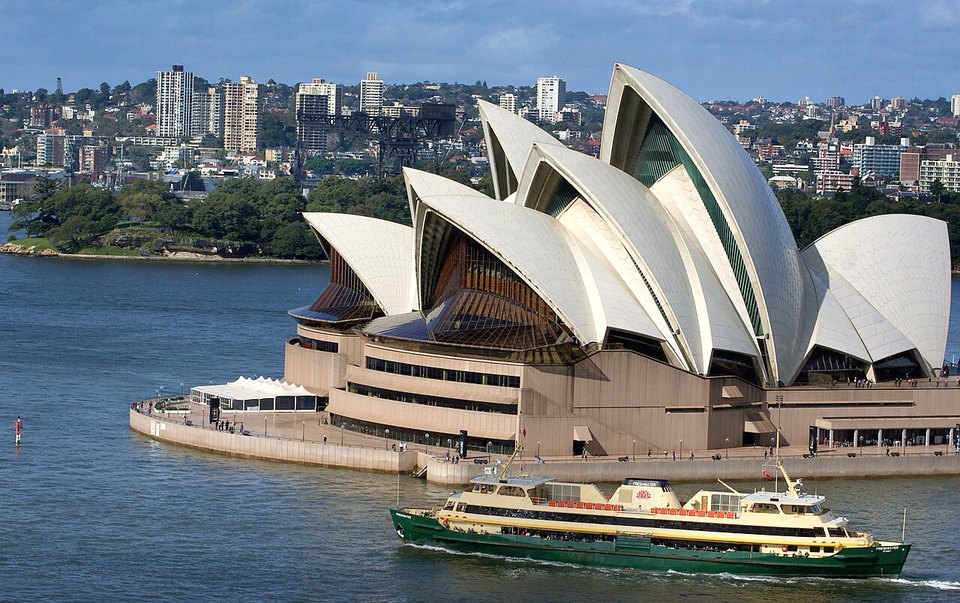
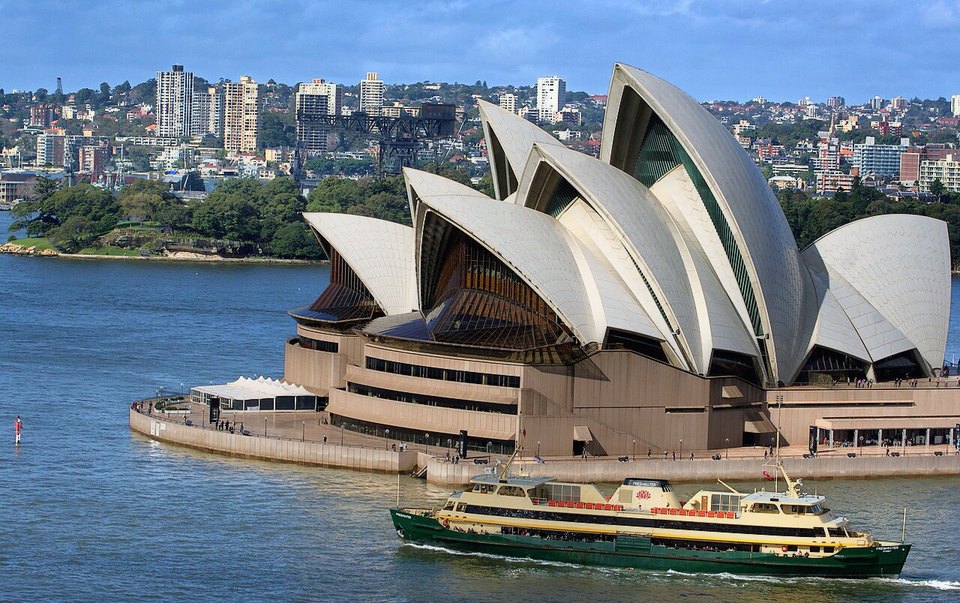
Exterior de mediodía, con blancos fuertes y cielo azul. Foto: Bernard Spragg, CC0.
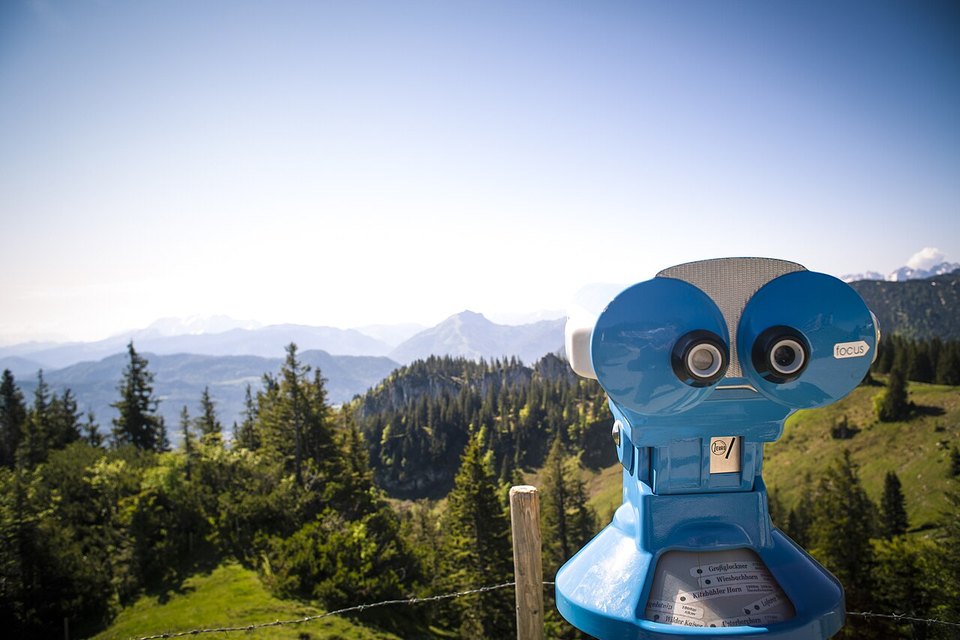
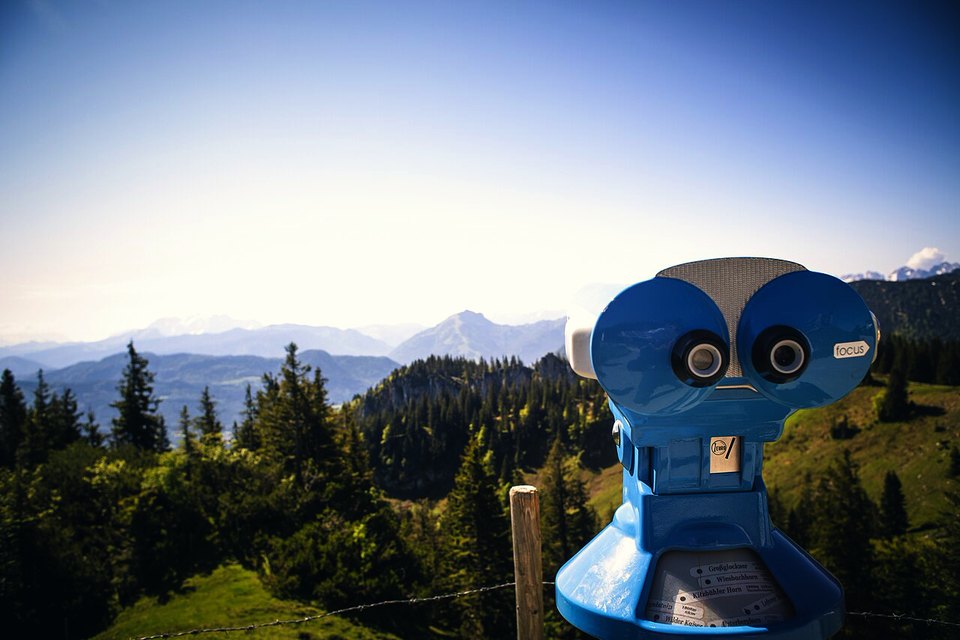
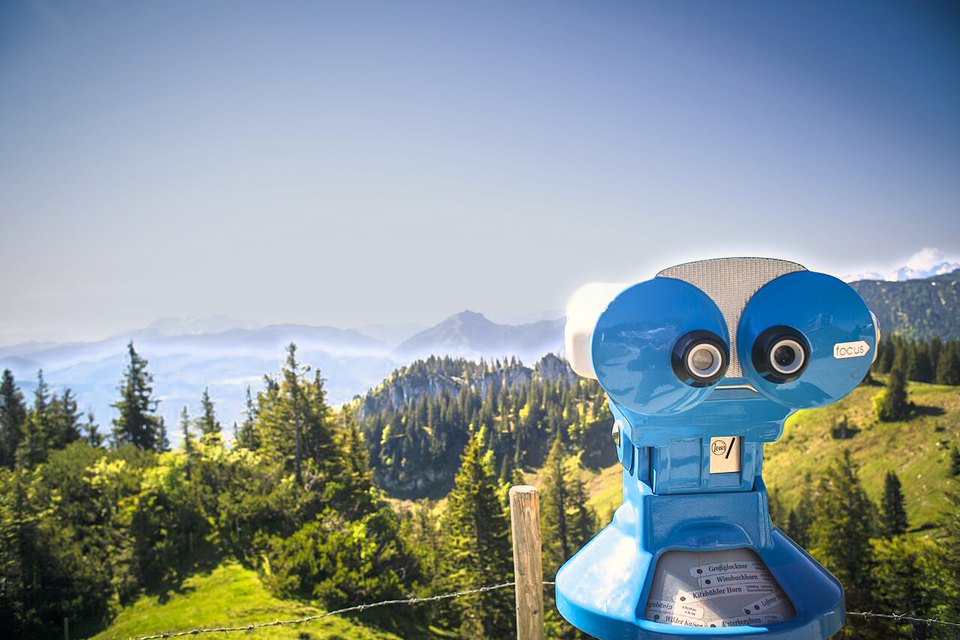
Cielo azul con zonas quemadas y un objeto en primer plano. El preset baja el cielo y aplana su textura: es el peor dato de estructura de la serie (ver abajo). Foto: Markus Spiske, CC0.
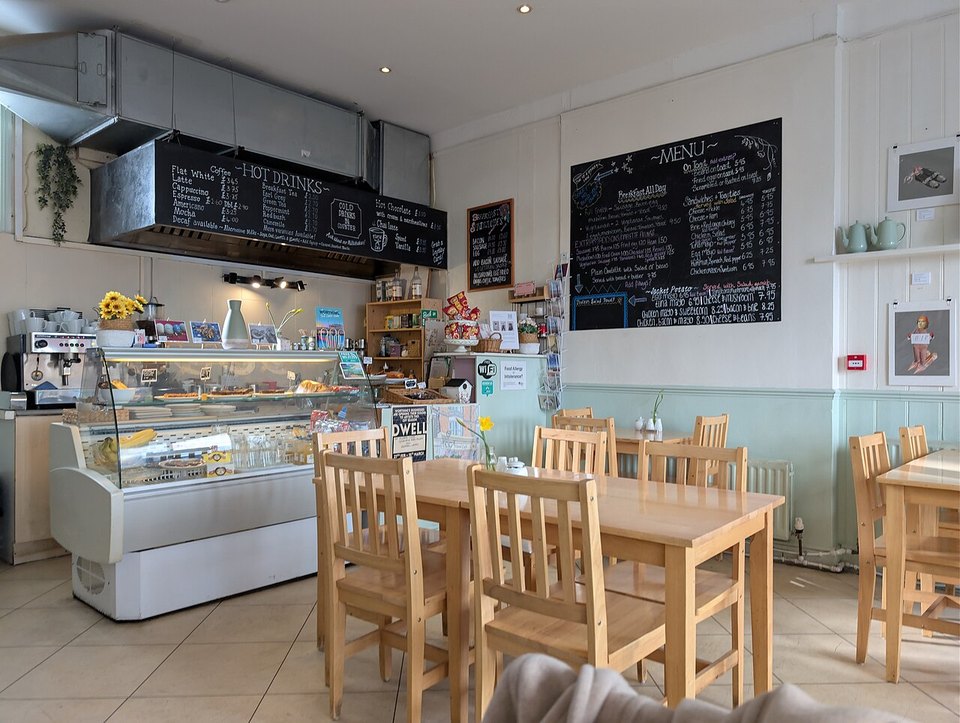
Interior con luz mixta, sin personas. Foto: Andy Li, CC0.
Números
| Concepto | Valor |
|---|---|
| GPU | NVIDIA RTX 4090 (24 GB), compartida con otros contenedores en reposo |
| Foto de entrada → salida | 1280 px lado largo → 2560 px |
| Tiempo por foto, en caliente (mediana) | 5,94 s (4,9–7,5 s) |
| Misma foto, versión clásica sin IA | 0,85 s |
| VRAM sobre la base (pico de la tarjeta) | 2,9 GB |
| Coste por foto, ESTIMACIÓN | 0,0015 $ = segundos × 0,89 $/h, precio listado de RunPod para RTX 4090 en https://www.runpod.io/pricing el 2026-10-16. Supone GPU ocupada al 100 %, sin arranques en frío ni almacenamiento; no se ha usado hardware alquilado. |
La mitad del tiempo del preset son dos etapas sin optimizar (recuperación de exposición 2,5 s y segmentación 1,9 s). El «primer run tras liberar modelos» (5,0 s) no es un arranque en frío real: los archivos estaban en caché del sistema.
Fidelidad: ¿se conserva la estructura?
| Región | Preset | Clásico | Peor foto del preset |
|---|---|---|---|
| Sujeto | 0,984 | 0,961 | 0,953 |
| Banda de borde (pelo) | 0,970 | 0,981 | 0,943 |
| Cielo (solo 3 fotos) | 0,909 | 0,994 | 0,800 |
| Resto | 0,980 | 0,986 | 0,945 |
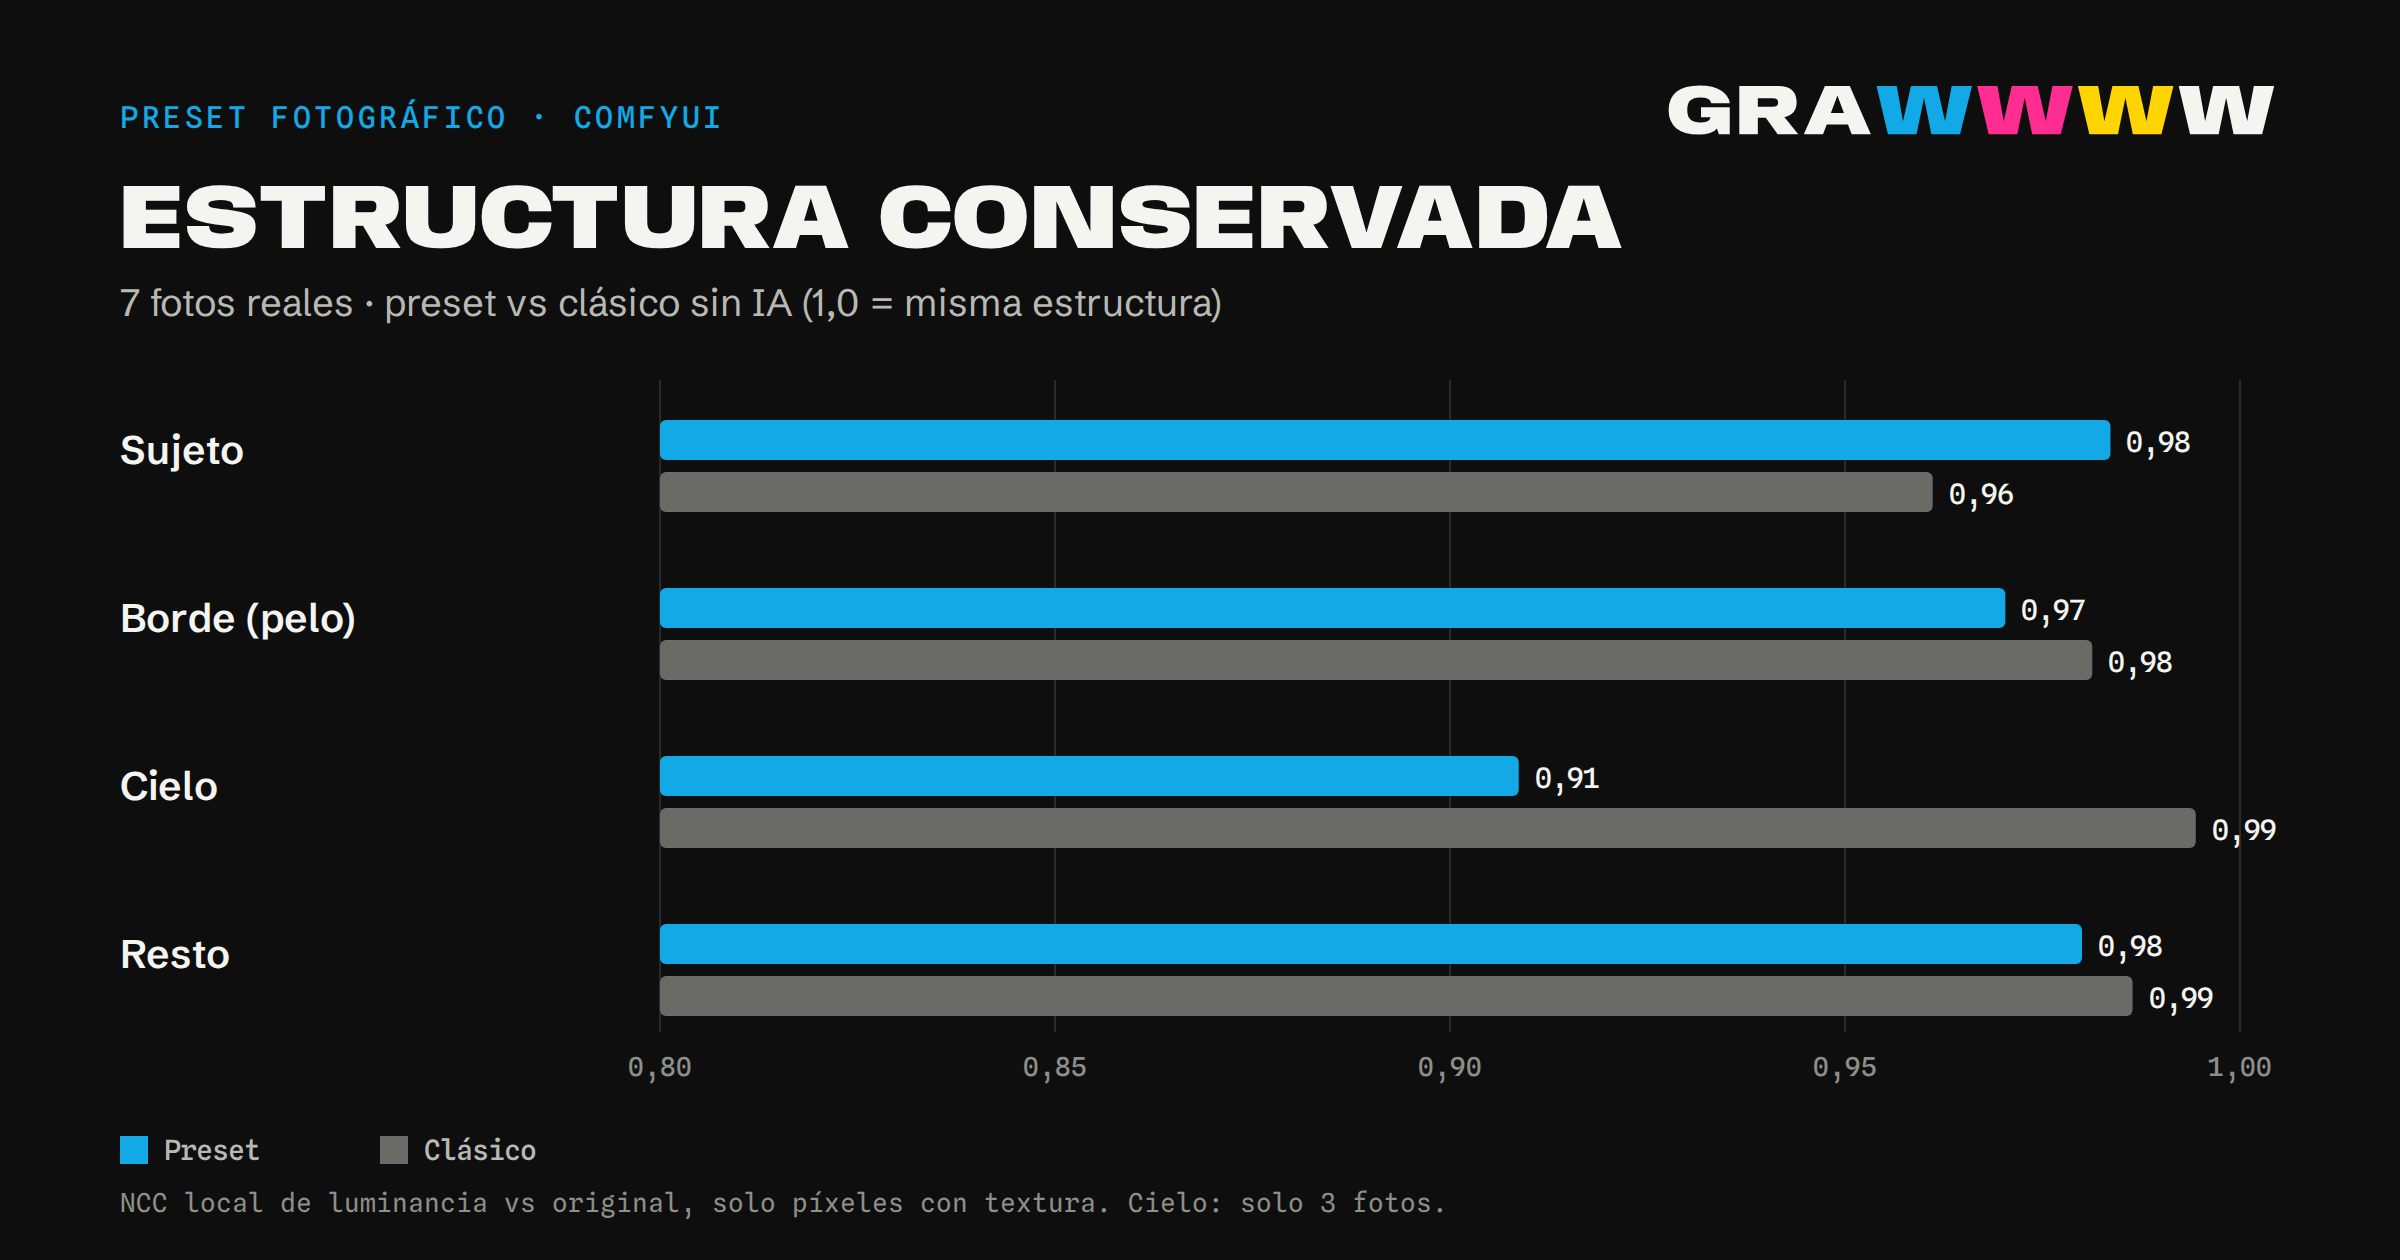
Correlación cruzada normalizada local de la luminancia contra el original, solo en píxeles con textura (1,0 = misma estructura; una edición de exposición o color no la cambia, una estructura inventada o destruida sí). En el sujeto el preset conserva mejor la estructura que el clásico; en el cielo es peor: el hombro de altas luces aplana la textura de cielos claros.
- Color: el preset mueve el color del sujeto menos que el clásico (ΔE medio 8,0 frente a 14,1) y casi no cambia el tono (2,9° frente a 9,5°). Son medidas de cuánto se movió, no de error: no hay una imagen «correcta».
- Escalado x2: al reducir de nuevo el resultado 2x, coincide con la imagen de partida a 39,4 dB de PSNR (Lanczos solo: 41,1 dB; el modelo SPAN sin anclaje: 32,5 dB y oscurecía la imagen). Aun así añade ×1,34 más energía de detalle: es la nitidez, y también lo que no podemos certificar como «no inventado».
- Nodo de LUT: frente a una implementación numpy independiente que lee el mismo
.cube, la diferencia máxima es 1/255 y el 98,5 % de los píxeles es idéntico. - Determinismo: dos ejecuciones repetidas dan imágenes idénticas (98 pares de PNG comparados, diferencia máxima 0).
7 fotos, 3 repeticiones, una GPU, un preset ajustado a mano sobre este tipo de fotos: es una prueba de método, no un benchmark.
Qué sigue fallando y qué no hicimos
- El cielo se detecta con una heurística, no con un modelo. De las 4 fotos con cielo lo encuentra bien en 2, se niega en 2 (nieve blanca, bruma beige) y da un falso positivo en una calle (edificios en sombra).
- Lo quemado no se recupera: en la foto más sobreexpuesta de la serie (11,5 % de píxeles quemados) queda gris plano, porque el detalle nunca estuvo en el archivo. Un modelo generativo «inventaría» ahí, justo lo que este trabajo no permite; no probamos ninguno.
- Contraluz fuerte: la subida de sombras está limitada para no amplificar ruido, así que un sujeto muy oscuro sigue oscuro.
- El refinado del recorte es mixto: alinea mejor los bordes por nuestro indicador (0,60 frente a 0,51, sin recorte de referencia: no es una medida de precisión), pero mete rayas en una foto con fondo muy claro. Además BiRefNet devuelve «el objeto saliente», no «la persona».
- No hicimos: segmentación de piel, relight generativo, LoRA de estilo de un fotógrafo ni despliegue en la nube (el Dockerfile no se ha construido y nada corrió en RunPod ni Modal). Tampoco medimos arranque en frío, concurrencia ni otras tarjetas.
Qué recibe un cliente
Lo mismo que ves aquí, aplicado a tu pipeline: tus presets convertidos en workflows de ComfyUI con una API estable para tu backend, nodos a medida para la lógica que hoy vive en tu Python (gradación, máscaras, recuperación de exposición), versiones y modelos fijados con su licencia comprobada, una evaluación con tu set de fotos y una lista honesta de lo que falla.
Herramientas a medida (extensiones, nodos, plugins y conectores): desde 600 €, sin IVA. Es un precio de partida: tras la primera conversación, la propuesta cierra el alcance y el precio. Detalle en Equipos técnicos, o escríbenos a hello@grawwww.xyz. Respondemos en menos de 48 horas.
Créditos y licencias
- BiRefNet (recorte), licencia MIT.
- Escalado: 2xNomosUni_span_multijpg de Philip Hofmann, CC BY 4.0 (https://huggingface.co/Phips/2xNomosUni_span_multijpg). La licencia del conjunto de entrenamiento no se ha verificado.
- ComfyUI (GPL-3.0): lo usamos tal cual, sin modificarlo ni distribuirlo; nuestro paquete de nodos es un plug-in aparte, con licencia MIT.
- Fotos de prueba: CC0, de Wikimedia Commons (autores y archivos en el repositorio). Una foto se retiró antes de publicar porque mostraba a una persona identificable sin autorización de imagen.
- Nuestro código, README y resultados: licencia MIT. No se redistribuyen pesos de modelos.