

Un fine-tune reproducible con la medición a la vista: tildes del vietnamita con CANINE-s
Prueba propia de portfolio, no un trabajo de cliente. Datos públicos (Wikipedia en vietnamita), modelo con licencia abierta y código en un repositorio que puedes ejecutar tú.
El problema
Quien quiere encargar un ajuste fino de un modelo tiene una pregunta razonable: «enséñame un repositorio donde hayas afinado un modelo y medido algo». No una demo, sino algo que se pueda clonar, ejecutar y comprobar. Este es nuestro: un fine-tune pequeño, con la medición antes y después, con las referencias simples con las que hay que compararlo y con una sección de lo que no funcionó.
Qué hicimos
La tarea. Restaurar las marcas del vietnamita: entra una frase con todas las tildes quitadas (la đ pasa a d) y sale la frase correcta. Usamos CANINE-s (Google, unos 0,13B parámetros, trabaja con caracteres, sin vocabulario de tokens) con una capa de clasificación que predice, para cada carácter, qué marcas lleva (36 etiquetas, una de ellas «ninguna»). El texto se reconstruye componiendo cada carácter de entrada con sus marcas, así que el modelo no puede cambiar una letra base: una aserción lo comprueba en cada frase de test (0 cambios).
- Por qué vietnamita y no árabe. El corpus estándar de diacritización árabe, Tashkeela, es GPL-2.0, y las copias etiquetadas MIT o Apache-2.0 son de procedencia sin verificar (no la comprobamos). La tarea tiene la misma forma (restaurar marcas sobre letras), así que usamos un corpus cuya licencia podíamos leer en la fuente. No se ha ejecutado nada en árabe.
- Un comando.
./run.shcrea el entorno con versiones fijadas, descarga datos y modelo, prepara las particiones, entrena, evalúa y escriberesults.mdyresults.json. Necesita Linux, una GPU NVIDIA,uvy unos 0,8 GB de descargas. - Partición por artículo, sin fugas. Cada frase va a test, validación o entrenamiento según el hash SHA-1 del título del artículo, así que un mismo artículo nunca está en dos partes. Se eliminan duplicados exactos y se comprueba por aserción que ninguna frase de entrenamiento está en test. Usamos 400.000 frases de entrenamiento, 2.000 de validación y 5.000 de test (2.314 artículos).
- Referencias simples. Un ajuste fino solo significa algo frente a algo. Medimos copiar la entrada y una tabla con la forma más frecuente de cada sílaba vista en el entrenamiento (la referencia que importa), además del modelo sin ajustar.
- Intervalos de confianza. Bootstrap por frase, 1.000 remuestreos.
Qué medimos
| Sistema | Sílabas bien | IC 95 % sílabas | Letras bien | Frase exacta |
|---|---|---|---|---|
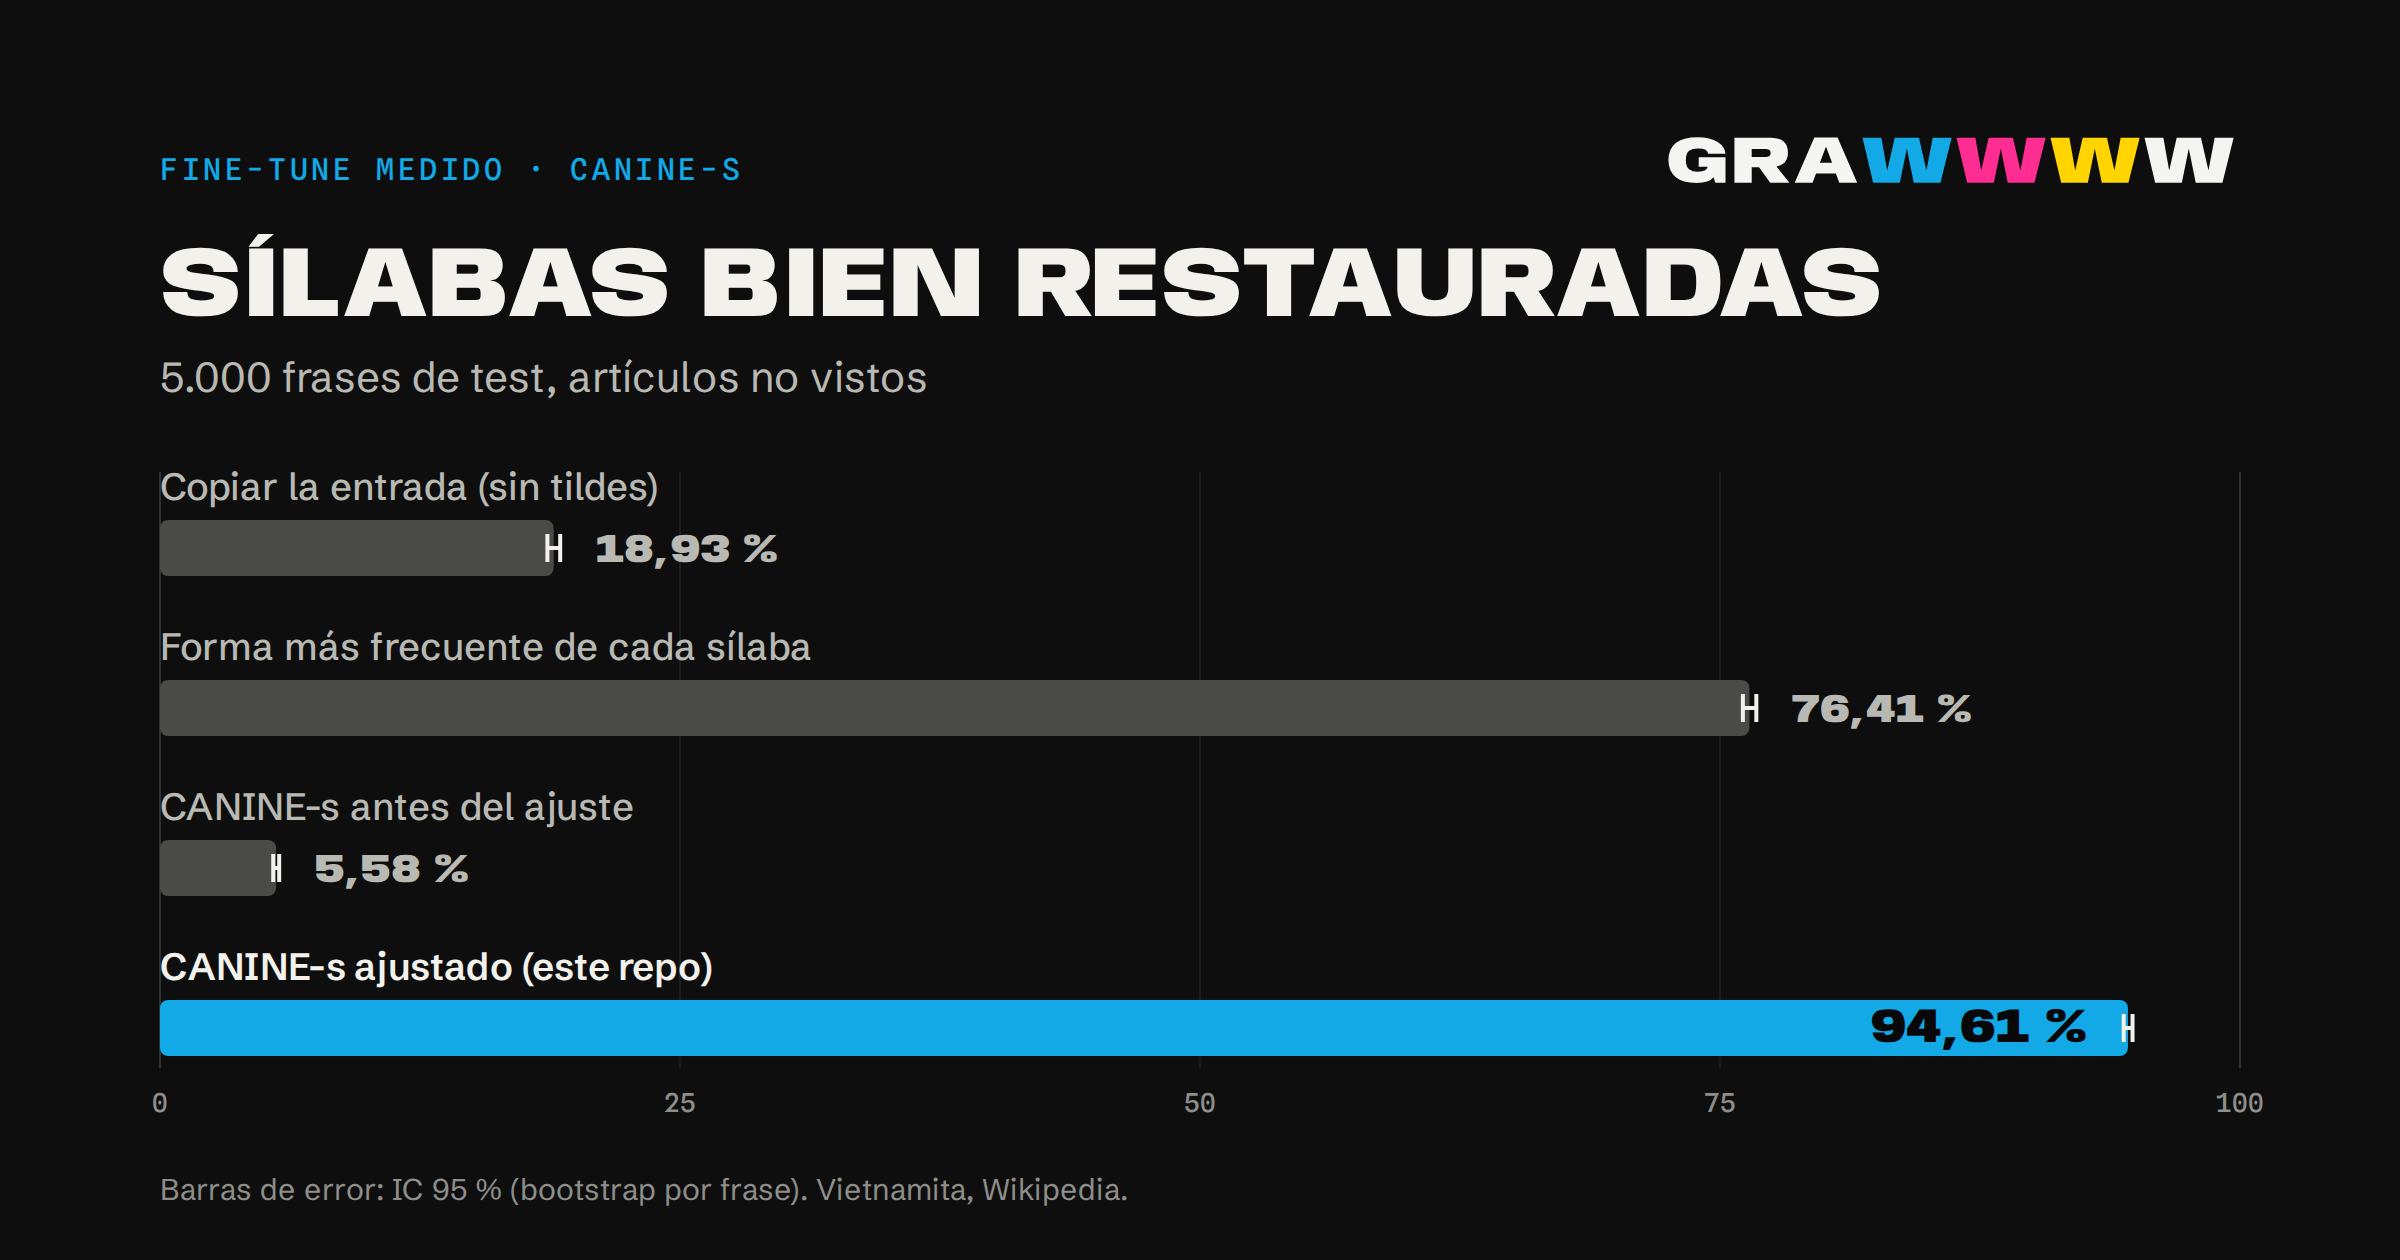
| Copiar la entrada (sin tildes) | 18,93 % | 18,63–19,24 | 74,05 % | 0,00 % |
| Referencia: forma más frecuente de cada sílaba vista en el entrenamiento | 76,41 % | 76,10–76,75 | 93,09 % | 4,44 % |
| CANINE-s antes del ajuste (cabeza aleatoria) | 5,58 % | 5,44–5,73 | 55,32 % | 0,00 % |
| CANINE-s ajustado (este repositorio) | 94,61 % | 94,41–94,83 | 98,41 % | 47,96 % |
Las sílabas son los tokens separados por espacios, sin signos de puntuación, y cuentan solo si coinciden exactamente con el original. La precisión por letra incluye las muchas letras que no llevan marca, por eso «copiar la entrada» no da cero. Pasamos de un 23,59 % de sílabas erróneas con la tabla de formas frecuentes a un 5,39 %.
La fila «antes del ajuste» es el codificador preentrenado con una cabeza inicializada al azar. Demuestra que la tarea no la resuelve el modelo preentrenado solo, pero no es una referencia fuerte: la que cuenta es la tabla de formas frecuentes.
Repetición. Ejecutamos todo el pipeline dos veces desde el mismo entorno fijado. Los tres archivos de datos salieron idénticos byte a byte (sha256). Los resultados del modelo no: 94,58 % la primera vez y 94,61 % la segunda, porque los núcleos de GPU no van en modo determinista. Cuenta con diferencias de unas centésimas de punto entre ejecuciones.
Cuánto cuesta: GPU y VRAM
| Concepto | Valor |
|---|---|
| GPU | NVIDIA RTX 4090 (compartida con otros trabajos; solo contamos nuestro proceso para la VRAM) |
| Entrenamiento | 18.750 pasos, lote 64, 3 épocas sobre 400.000 frases, lr 5e-5, bf16 |
| Tiempo de entrenamiento | 19,5 min |
| GPU, entrenar + evaluar (con carga del modelo) | 0,34 GPU-horas (20,3 min) |
| VRAM máxima, entrenamiento (asignada / reservada) | 4,72 / 5,87 GB |
| VRAM máxima, inferencia sobre el test | 1,95 GB |
| Velocidad de inferencia | 5.990 frases/s (lote 128) |
| Preparación de datos (CPU) | 812 s |
| Pipeline completo (`run.sh`) | 33,8 min |
Coste estimado si se alquilara la misma tarjeta, con la tarifa pública de RunPod leída en https://www.runpod.io/pricing el 2026-10-16 (la página indicaba actualizada el 2026-10-08): RTX 4090, Community Cloud 0,34 $/h, Secure Cloud 0,89 $/h.
| Alcance | Horas | Community | Secure |
|---|---|---|---|
| Solo GPU | 0,34 h | 0,11 $ | 0,30 $ |
| Pipeline completo, con datos | 0,56 h | 0,19 $ | 0,50 $ |
Es una estimación, no una factura: los precios cambian. Lo ejecutamos en nuestra propia tarjeta y no pagamos GPU.
Ejemplos de errores
Ejemplos del test, con el título del artículo de Wikipedia. La entrada es la frase original sin tildes. En rosa, las sílabas que no coinciden con el original. Son los tres primeros de cada lista, tomados de un barajado con semilla, no elegidos.
El modelo acierta y la referencia falla
Artículo: Wilhelm II, Hoàng đế Đức
- Entrada (sin tildes)
- Voi tinh khi khac thuong, ong thuong noi the nay nhung lai lam the khac.
- Original
- Với tính khí khác thường, ông thường nói thế này nhưng lại làm thế khác.
- Referencia (formas frecuentes)
- Với tỉnh khi khác thường, ông thường nơi thể này những lại làm thể khác.
- Modelo ajustado
- Với tính khí khác thường, ông thường nói thế này nhưng lại làm thế khác.
Artículo: Darin
- Entrada (sin tildes)
- Exit bao gom cac bai hat "Nobody Knows", "Playing With Fire", "Check You Out" va "Before I Pass Out", voi phan sau chua cac tinh nang cua rapper Lil Jon.
- Original
- Exit bao gồm các bài hát "Nobody Knows", "Playing With Fire", "Check You Out" và "Before I Pass Out", với phần sau chứa các tính năng của rapper Lil Jon.
- Referencia (formas frecuentes)
- Exit bao gồm các bài hát "Nobody Knows", "Playing With Fire", "Check You Out" và "Before I Pass Out", với phần sau chưa các tỉnh năng của rapper Lil Jon.
- Modelo ajustado
- Exit bao gồm các bài hát "Nobody Knows", "Playing With Fire", "Check You Out" và "Before I Pass Out", với phần sau chứa các tính năng của rapper Lil Jon.
Artículo: Thổ Nhĩ Kỳ
- Entrada (sin tildes)
- Tai tay bac Tho Nhi Ky, nhom bo toc quan trong nhat tai Thrace la Odyrisia.
- Original
- Tại tây bắc Thổ Nhĩ Kỳ, nhóm bộ tộc quan trọng nhất tại Thrace là Odyrisia.
- Referencia (formas frecuentes)
- Tại tây bắc Thổ Nhĩ Kỳ, nhóm bộ tộc quân trong nhất tại Thrace là Odyrisia.
- Modelo ajustado
- Tại tây bắc Thổ Nhĩ Kỳ, nhóm bộ tộc quan trọng nhất tại Thrace là Odyrisia.
El modelo falla
Artículo: Gia phả
- Entrada (sin tildes)
- O Tay phuong, nguoi ta co tap tuc lam cay pha he hay pha do, tuong tu nhu Tong do cua nguoi Hoa hay nguoi Viet.
- Original
- Ở Tây phương, người ta có tập tục làm cây phả hệ hay phả đồ, tương tự như Tông đồ của người Hoa hay người Việt.
- Referencia (formas frecuentes)
- Ở Tây phương, người ta có tập tục làm cây phá hệ hay phá đó, tướng từ như Tổng đó của người Hoa hay người Việt.
- Modelo ajustado
- Ở Tây phương, người ta có tập tục làm cây phà hệ hay phá đỡ, tương tự như Tông đồ của người Hoa hay người Việt.
Artículo: Chùa Shwedagon
- Entrada (sin tildes)
- Stupa (phu do) tung bi hu hai suot mot thoi gian dai va duoc Vua Binnya U cua Hanthawaddy sua lai.
- Original
- Stupa (phù đồ) từng bị hư hại suốt một thời gian dài và được Vua Binnya U của Hanthawaddy sửa lại.
- Referencia (formas frecuentes)
- Stupa (phủ đó) từng bị hư hai suốt một thời gian đại và được Vua Binnya U của Hanthawaddy sửa lại.
- Modelo ajustado
- Stupa (phụ đó) từng bị hư hại suốt một thời gian dài và được Vua Binnya U của Hanthawaddy sửa lại.
Artículo: Adolf Hitler
- Entrada (sin tildes)
- Trong thoi gian xay ra cuoc khung hoang, Hitler tu bo nhiem minh lam nguoi dung dau Oberkommando des Heeres (Bo Tong tu lenh Luc quan).
- Original
- Trong thời gian xảy ra cuộc khủng hoảng, Hitler tự bổ nhiệm mình làm người đứng đầu Oberkommando des Heeres (Bộ Tổng tư lệnh Lục quân).
- Referencia (formas frecuentes)
- Trong thời gian xây ra cuộc khủng hoàng, Hitler từ bộ nhiệm mình làm người dụng đầu Oberkommando des Heeres (Bộ Tổng từ lệnh Lục quân).
- Modelo ajustado
- Trong thời gian xảy ra cuộc khủng hoảng, Hitler từ bổ nhiệm mình làm người đứng đầu Oberkommando des Heeres (Bộ Tổng tư lệnh Lục quân).
Los pares de errores más frecuentes son cambios entre palabras válidas: loại/loài, từ/tự, con/còn, cùng/cũng, quan/quân, cổ/có.
Qué falla todavía y qué no medimos
- El acierto por frase es modesto. Menos de la mitad de las frases de test (47,96 %) salen exactas; el 5,4 % de las sílabas es erróneo, así que una frase típica de 22 sílabas tiene aproximadamente un error (110.862 sílabas en 5.000 frases).
- Ambigüedad que el modelo no puede resolver con una sola frase. Algunos pares son realmente ambiguos sin más contexto, y el modelo ve una frase cada vez.
- Las convenciones ortográficas son ruido en las etiquetas. Wikipedia mezcla
hoá/hóayHoà/Hòa(colocación de la tilde). El modelo solo puede adivinar qué estilo usa cada artículo; aquí cuentan como error. - Nombres y palabras extranjeras. Los que no llevan marcas pasan sin cambios; los nombres sino-vietnamitas poco frecuentes suelen salir mal.
- Errores por el camino. El primer entrenamiento falló en validación porque una combinación de marcas imposible cambiaba la longitud del texto (la aserción de la letra base lo detectó y se corrigió). La primera evaluación falló porque un núcleo nativo de torch necesitaba un compilador de C. En la primera ejecución completa,
make_results.pyfalló por un número mal formateado entiming.jsony se corrigió a mano solo para esa ejecución; eltiming.jsondel resultado publicado lo escribió el script ya corregido. No se guardaron registros de esos intentos fallidos, salvo la ejecución preliminar de 1 época. - No medido: variación entre semillas de entrenamiento (una semilla por ejecución, dos ejecuciones); otras tasas de aprendizaje o tamaños de lote; modelos más grandes o más datos (la validación seguía subiendo despacio al final, de 94,94 % a 95,21 % en los últimos 3.000 pasos); texto fuera de Wikipedia (noticias, chat, OCR); frases de más de 200 caracteres; comparación con sistemas publicados en vietnamita (nuestra partición y filtros son distintos, así que los números no son comparables); velocidad en CPU; cualquier idioma que no sea vietnamita. Las frases de test tienen al menos 5 letras con marca, así que en textos con pocas marcas el resultado puede ser distinto.
- La VRAM máxima es el pico del asignador de PyTorch de nuestro proceso en una tarjeta compartida con otros trabajos; el tiempo de GPU es el tiempo real de entrenar y evaluar, con la carga del modelo incluida.
Qué recibe un cliente
Lo mismo que ves aquí, aplicado a tus datos: el ajuste de un modelo para un producto, personaje, estilo o tarea, un repositorio o carpeta que se pueda volver a ejecutar, las referencias simples con las que se compara, la medición con tus casos reales antes de entregarlo y una lista honesta de lo que falla y de lo que no hemos medido.
Modelos a medida: desde 450 €, sin IVA. Es un precio de partida: tras la primera conversación, la propuesta cierra el alcance y el precio. Detalle en Equipos técnicos, o escríbenos a hello@grawwww.xyz. Respondemos en menos de 48 horas.
Créditos y licencias
- Modelo:
google/canine-s(CANINE-s), Apache-2.0. - Datos: Wikipedia en vietnamita (volcado de 2023-11-01, publicado por Wikimedia en Hugging Face), CC BY-SA y GFDL. Los fragmentos de texto de esta página son de Wikipedia, con el título del artículo; los autores están en el historial de cada artículo. No redistribuimos el corpus ni pesos entrenados.
- Nuestro código, README y resultados: licencia MIT.
- Si reentrenas y publicas pesos: léete antes los términos de CC BY-SA. No hemos pedido asesoramiento legal sobre si los pesos son obras derivadas, y no publicamos ninguno.