

Un personaje que no cambia entre escenas
Transparencia: vendemos trabajo de imagen generativa a equipos y usamos el sistema que describimos. Todas las imágenes de este artículo están generadas con IA. Salvo la comparativa de modelos base, que no usa LoRA, todas salen de nuestro LoRA propio, entrenado sobre un dataset sintético nuestro. La oferta está al final, marcada como tal. El resto se sostiene sin ella.
Un libro ilustrado necesita el mismo personaje en cientos de dibujos: misma cara, misma armadura, mismo trazo de tinta con rayado cruzado. Con solo el prompt, el personaje cambia de una imagen a otra. Lo comprobamos: sin entrenar nada, el nombre del personaje no significa nada para el modelo y devuelve un caballero genérico.
Tomamos como caso a Don Quijote, un personaje de dominio público, y construimos un montaje reutilizable en ComfyUI. Contamos cómo elegimos la base, cómo hicimos el dataset, qué entrenamos, qué salió y qué falla todavía.
Elegir la base
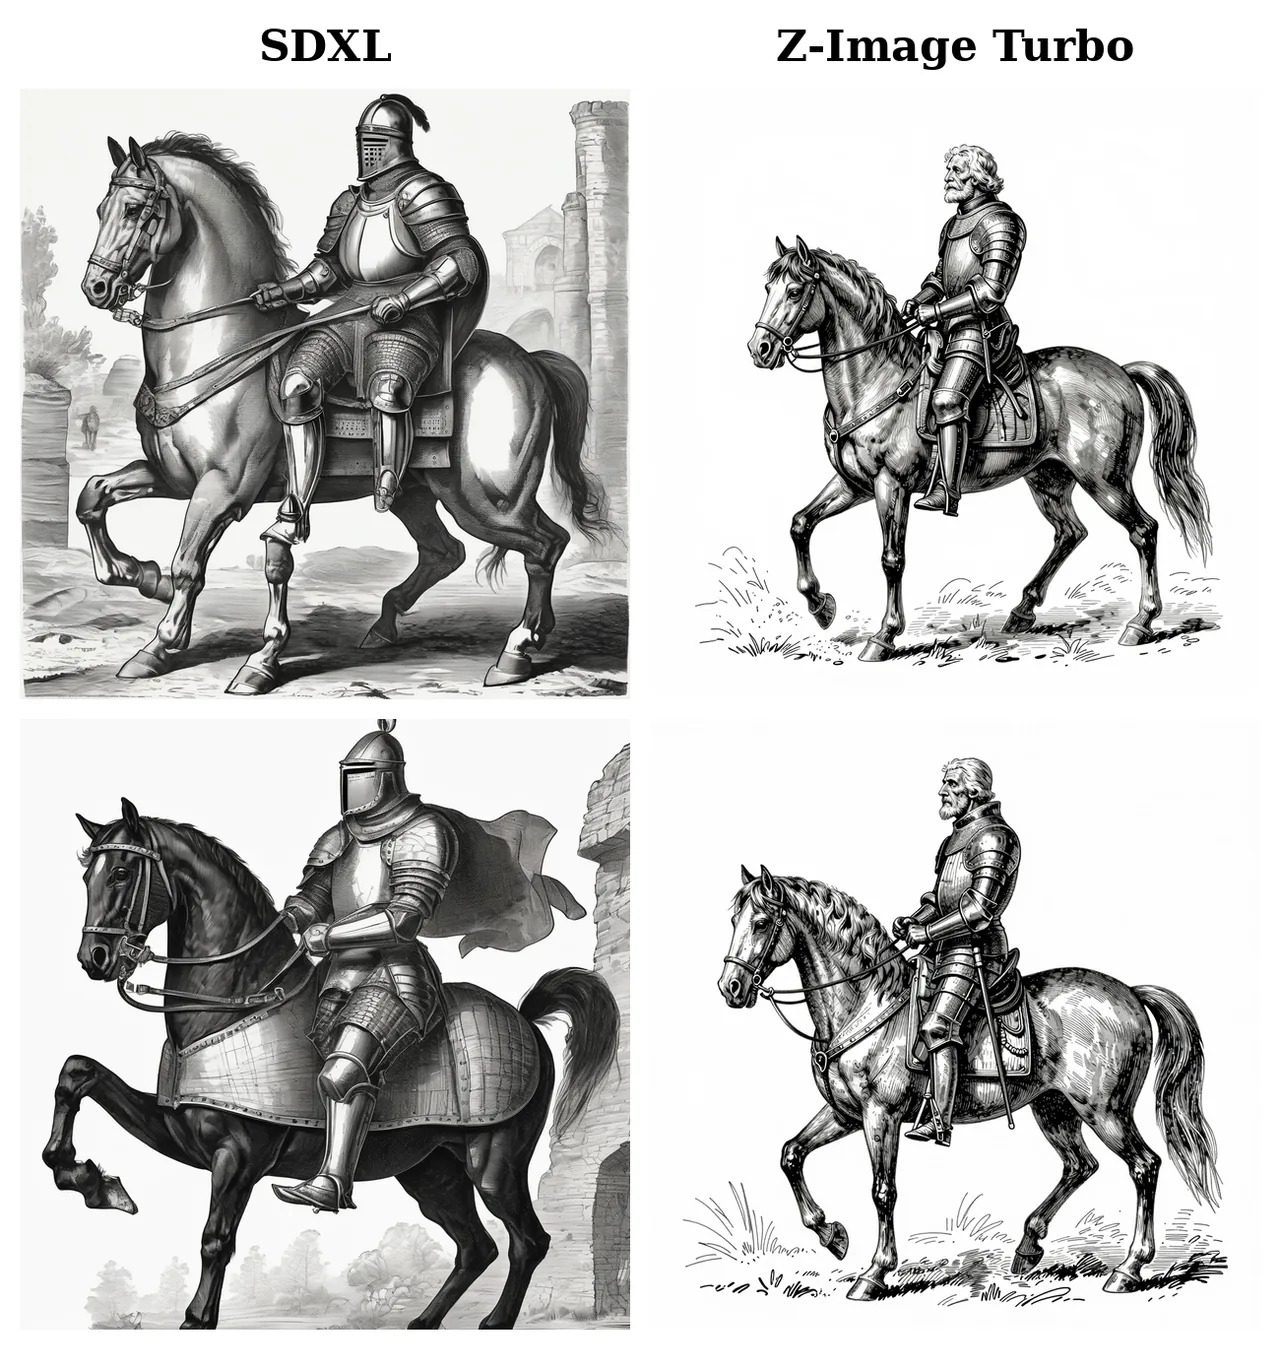
Probamos tres modelos base, sin LoRA, con 8 temas y 2 semillas cada uno (48 imágenes, ningún fallo), con el mismo prompt de plumilla y grabado del siglo XIX, en la misma RTX 4090.
| Base | Licencia | Pasos | s/imagen en caliente | Pico de VRAM (GPU entera) |
|---|---|---|---|---|
| SDXL 1.0 | OpenRAIL++-M, con condiciones | 30 | 4,29 | 11,2 GiB |
| Z-Image Turbo | Apache-2.0 | 8 | 4,02 | 23,2 GiB |
| Tercer modelo | Su licencia no encaja con una entrega a cliente | 8 | 6,29 | 20,2 GiB |
Elegimos Z-Image Turbo por tres cosas. Su licencia es Apache-2.0, según la ficha del modelo. Da línea negra limpia sobre fondo blanco, con el sombreado hecho de rayado y no de aguada. Y con 8 pasos tarda unos 4 s por imagen en caliente en una sola RTX 4090.
SDXL salió más gris, con papel crema y fondos rellenos aunque pedíamos fondo blanco. Pide la mitad de memoria de GPU, así que sigue siendo una opción si la tarjeta es pequeña. El tercer modelo daba el mejor rayado fino, pero su licencia no encaja con una entrega a un cliente. Lo usamos solo para comparar.
Nota de medición: el pico de VRAM es el de la GPU entera, con unos 2 GiB de otros procesos. El pico de Z-Image está cerca del límite de 24 GB.
El dataset: lo generamos nosotros
Lo natural era entrenar con dibujos escaneados de un libro de 1906. No lo hicimos. Esos dibujos son sobre todo escenas con varias figuras pequeñas, y lo que queríamos era un personaje grande y reconocible.
En su lugar escribimos una ficha del personaje: cara larga y delgada, barba gris en punta, bigote caído, casco de bacía, peto abollado. Con esa ficha generamos 236 candidatas variando encuadre (cuerpo entero, de rodillas arriba, medio cuerpo, primer plano, perfil), pose y vista. Nos quedamos con 32.
Los descartes fueron por motivos concretos. Un sombrero en forma de embudo en vez del casco. Cuatro imágenes con fugas de color marrón en el cuero y la piel, que solo se veían comprobando los números píxel a píxel. Cada imagen lleva un pie que describe lo visible (encuadre, pose, acción, vista) y nunca la cara, la barba ni la armadura: eso lo tiene que llevar la palabra clave del personaje.
Hay huecos conocidos: ninguna figura a medio cuerpo, ninguna risa de verdad, nada sentado a una mesa, casi todo sobre fondo blanco; algunas escenas al aire libre.
El entrenamiento
Un solo LoRA (rango 32) sobre Z-Image Turbo, con ai-toolkit. Guardamos un punto cada 500 pasos y probamos cinco variantes (sin LoRA; paso 1000 con fuerza 0,7 y 0,9; paso 1500; paso 2500) en 8 escenas nuevas, con 2 semillas: 80 imágenes.
Nos quedamos con el punto del paso 1000, con fuerza 0,9. Tarda unos 30 minutos en una RTX 4090 (estimado: 1.000 pasos a ~1,8 s por paso; la sesión completa de 2.500 pasos tardó 83 min). En el paso 1500 las peticiones de primer plano salían como medio cuerpo; en el 2500 no se repitió en la hoja revisada. Además la lanza, que aparece en 18 de las 22 figuras de cuerpo entero del dataset, empezaba a salir sin pedirla. El paso 1000 respeta el encuadre y la identidad. El de 2500 no era claramente mejor y arrastra más sesgo.
Resultados
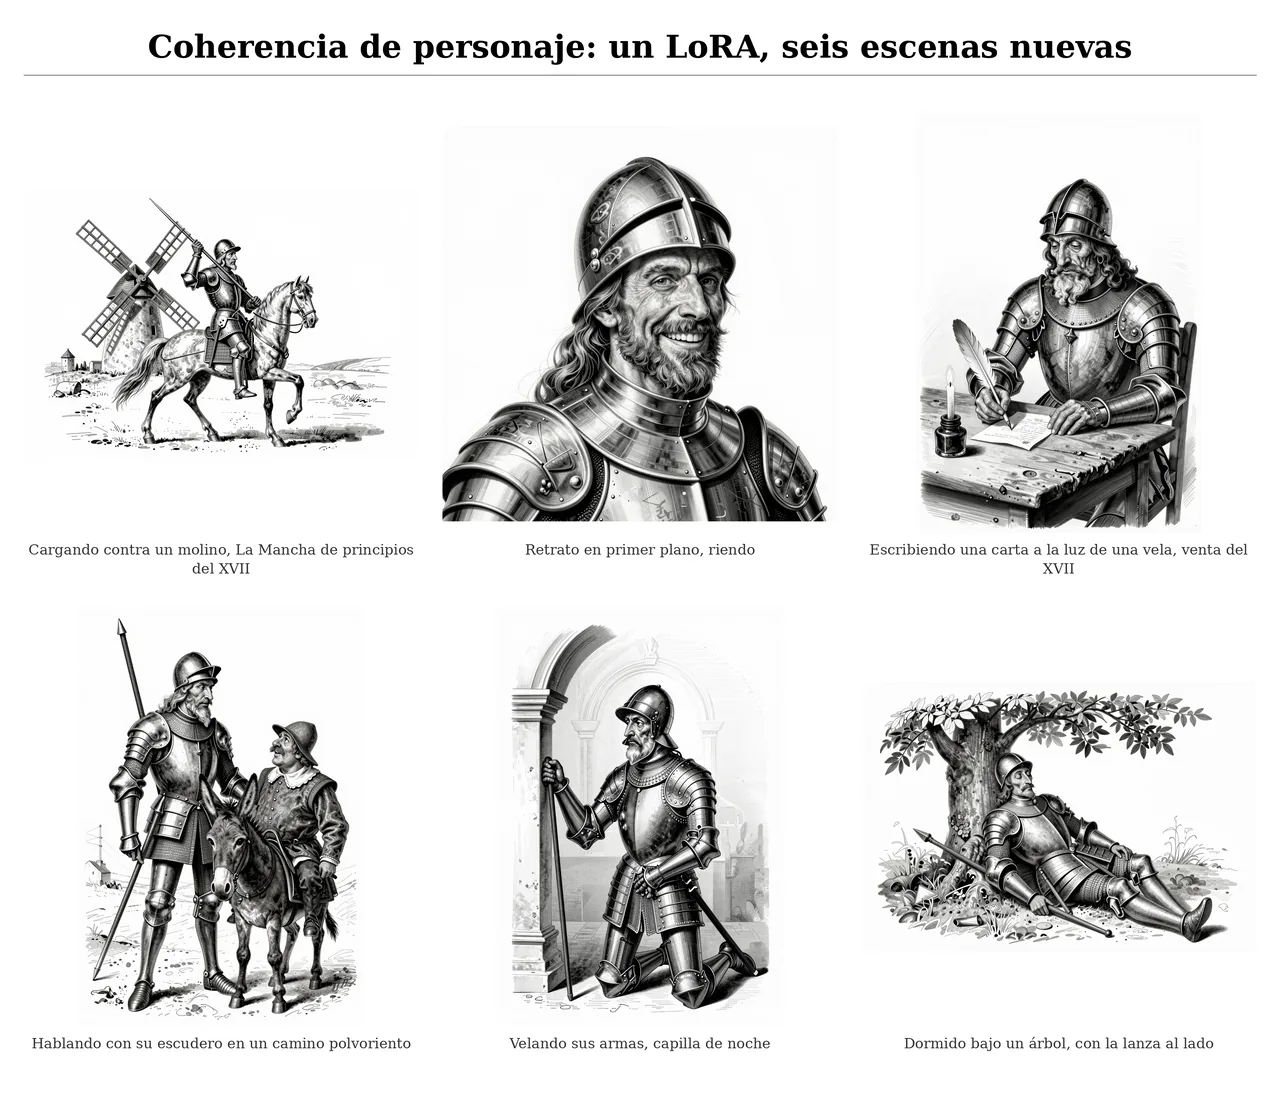
Seis escenas nuevas, todas con el mismo prompt de partida (cara visible, visera abierta) y 8 pasos:
- Cargando contra un molino con la lanza, a caballo (flaco).
- Primer plano riendo, de tres cuartos.
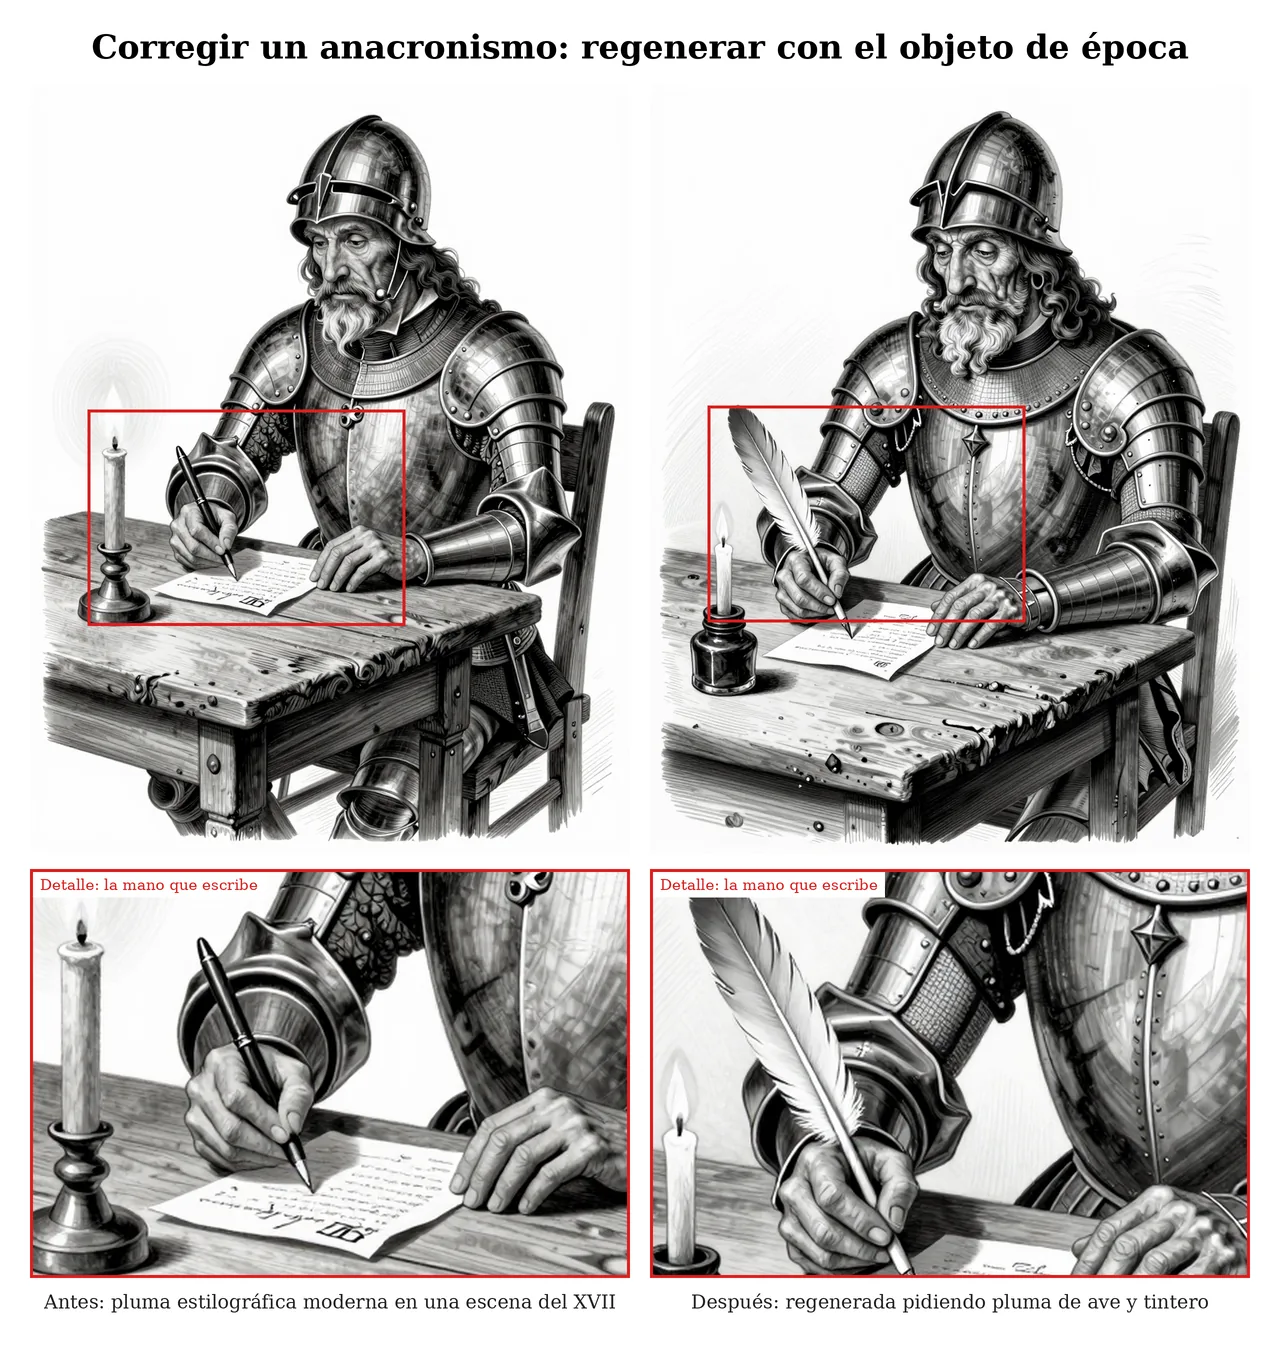
- Escribiendo una carta a la luz de una vela, en una venta.
- Hablando con un escudero bajo y rechoncho montado en un burro.
- De rodillas en una capilla, velando sus armas de noche.
- Dormido bajo un árbol con la lanza al lado.
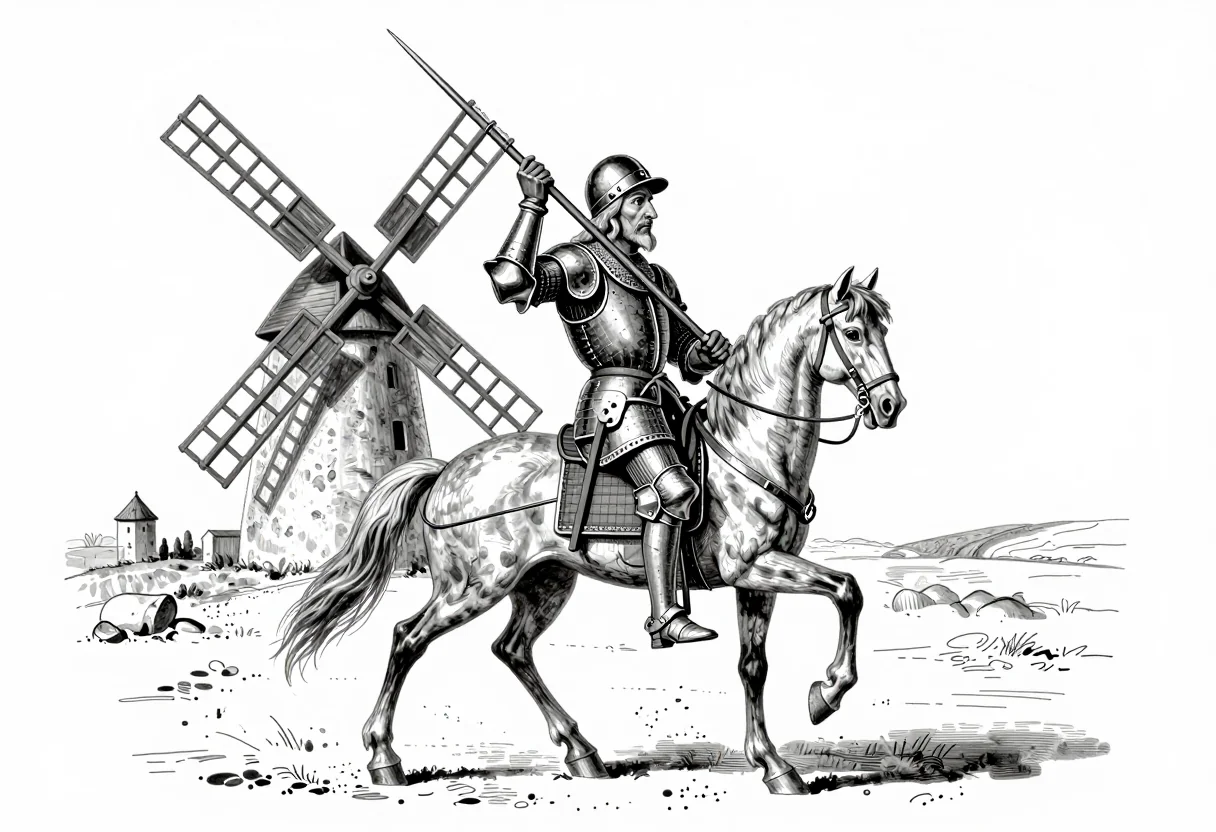
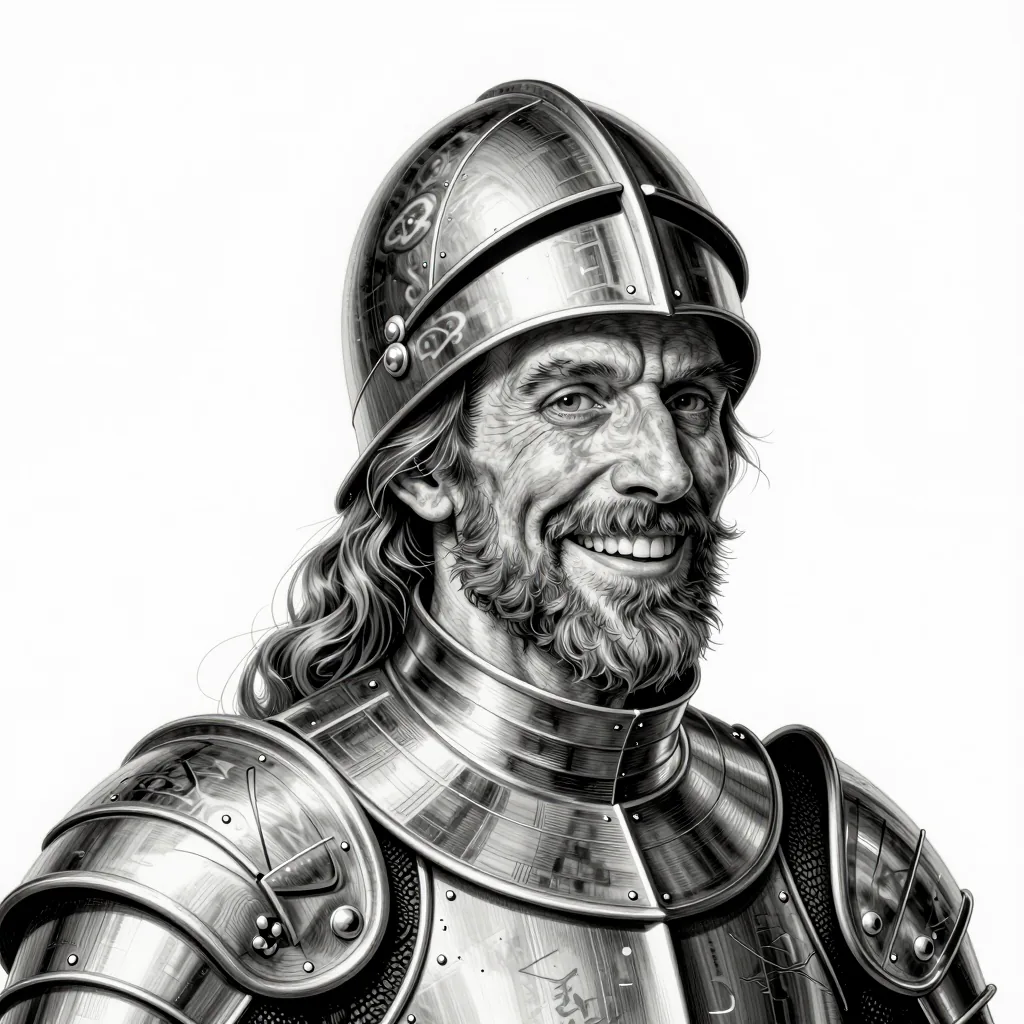
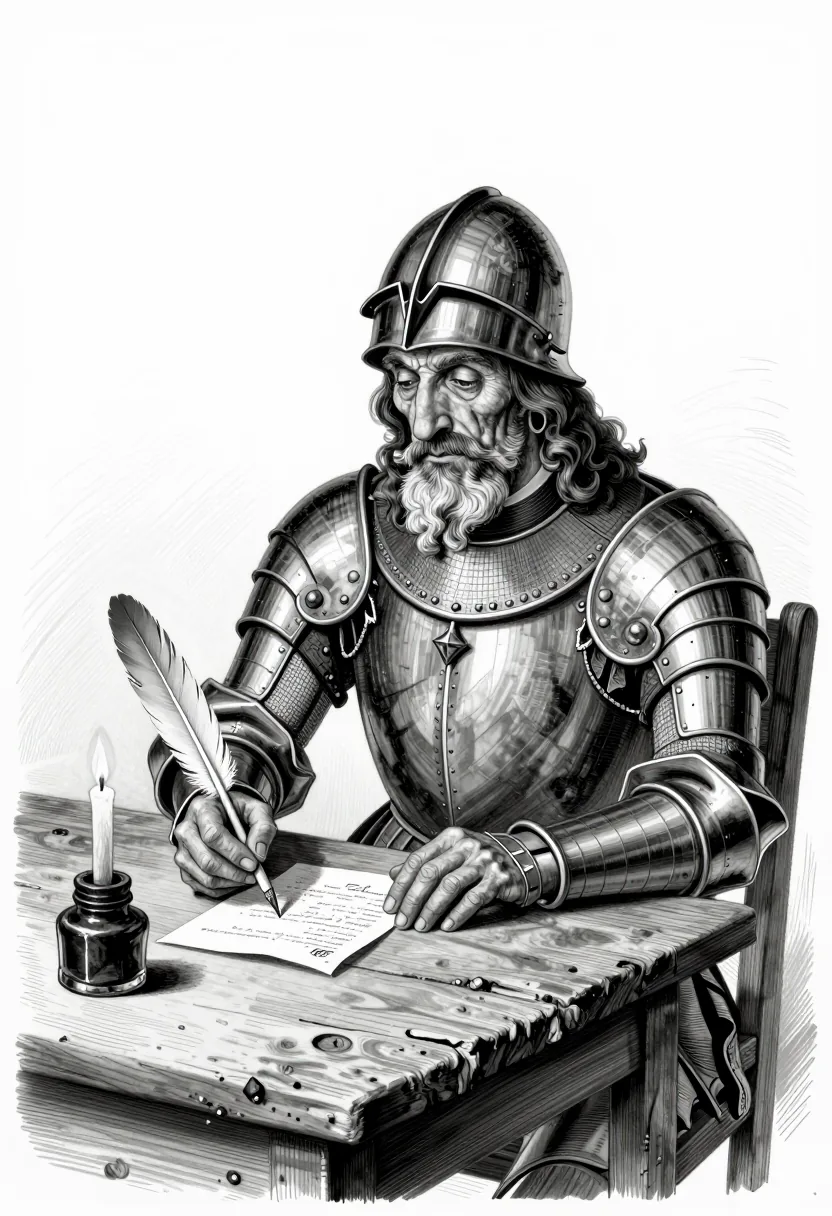
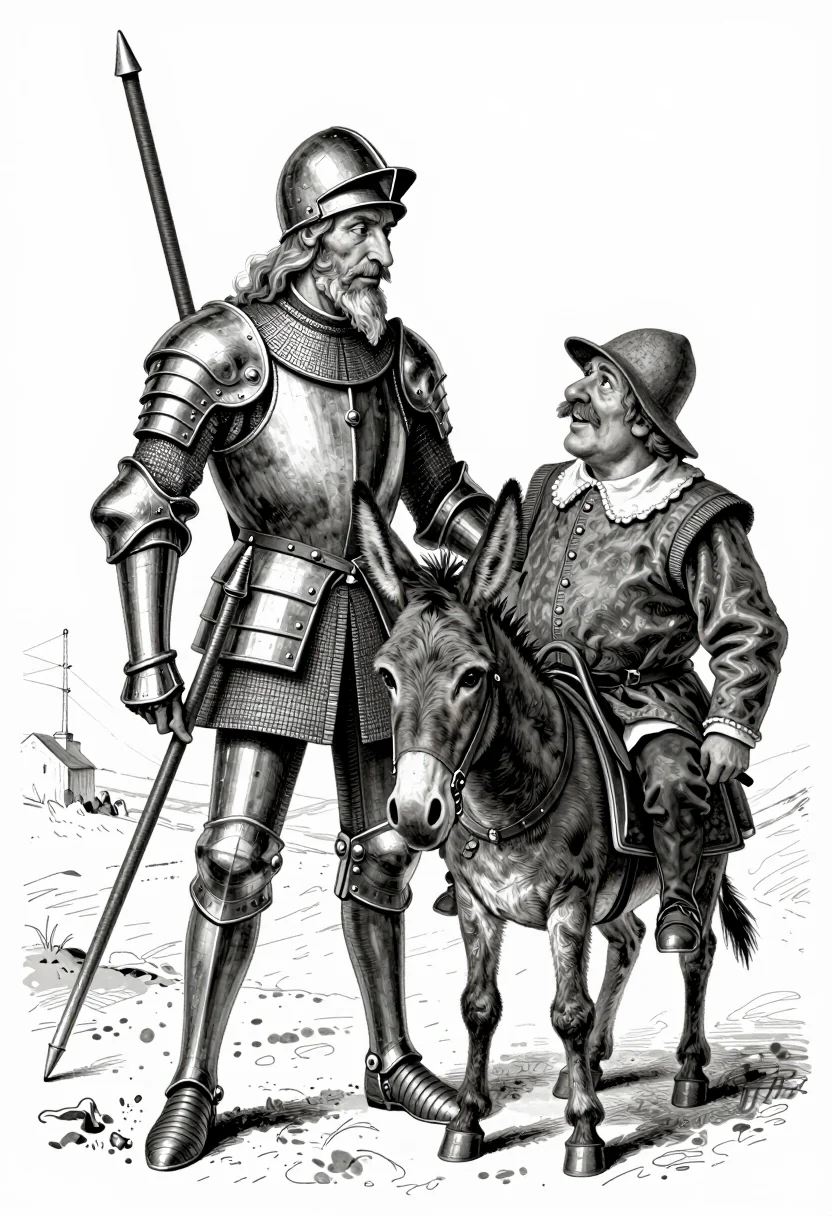
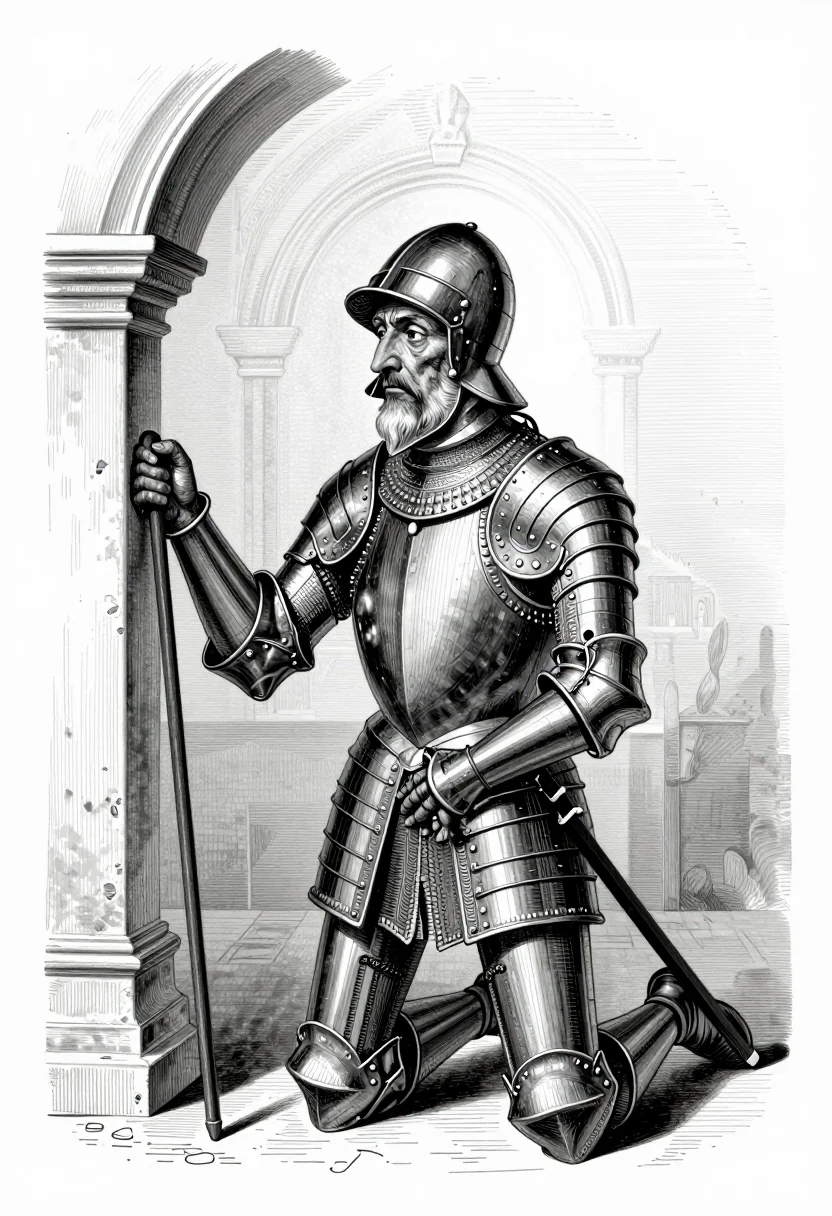
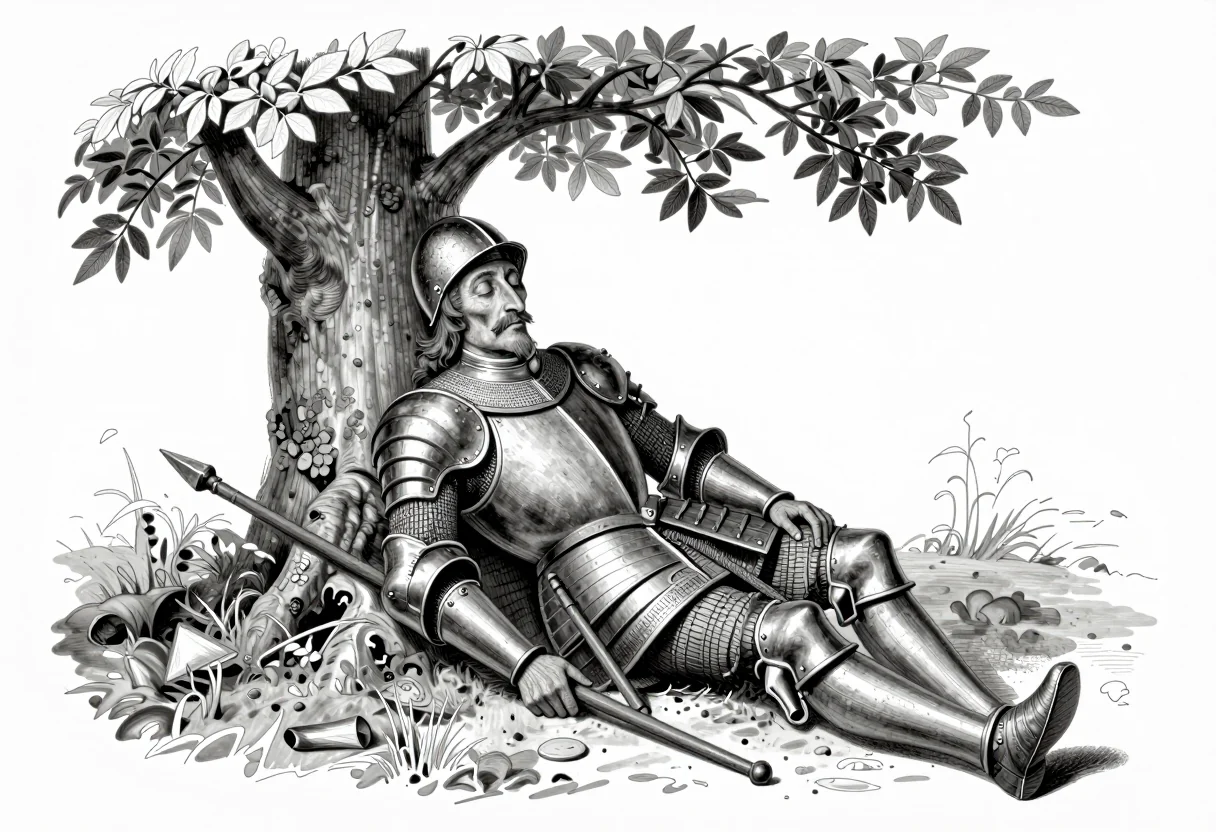
De cada escena generamos 4 variantes con semillas distintas y elegimos una. No son las cuatro de cada una: es la mejor de cuatro (la de la venta, de ocho, con pluma de ave y tintero pedidos en el prompt).
Corregir un anacronismo
Nuestra primera versión de la escena de la venta salió con una pluma estilográfica moderna en pleno siglo XVII. Intentamos cambiarla por inpainting y la pluma de ave salió pegada, como un recorte. Así que regeneramos la escena pidiendo en el prompt una pluma de ave y un tintero (la mejor de 8 semillas, el mismo LoRA, el mismo personaje).
Reparar un defecto: LaMa y el LoRA
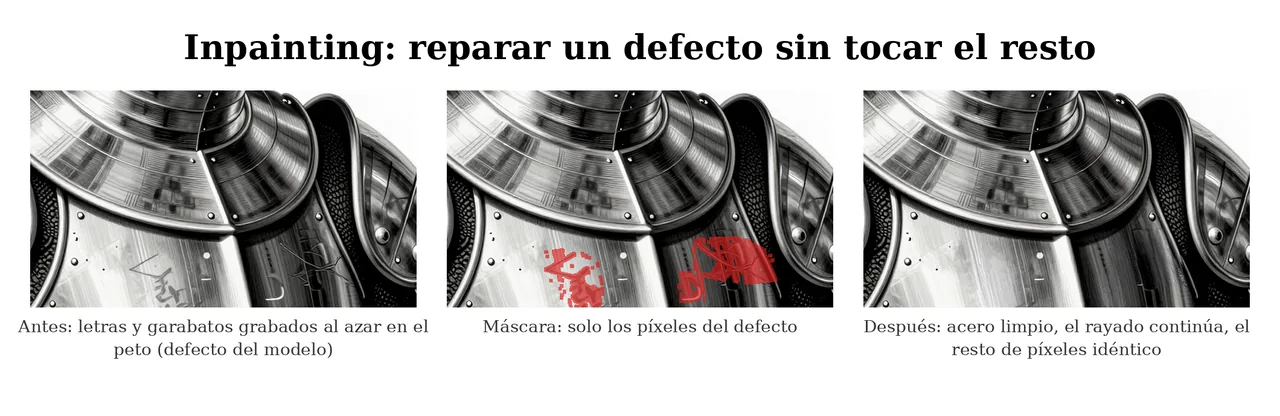
En el primer plano, el modelo grabó en la armadura marcas aleatorias con forma de letras. Pedirle a este modelo destilado que rellenara el hueco directamente inventaba cosas dentro (caras, manos, cascos) o dejaba manchas grises planas; probamos varias rondas. Lo que funciona son dos pasos. Primero, LaMa (un modelo de inpainting que rellena a partir de la textura de alrededor, sin inventar un motivo) elimina las marcas. Después, una pasada ligera con el LoRA del personaje (denoise 0,3, sobre recortes de 1024 px) devuelve el rayado. El resultado se pega a través de la máscara ampliada 4 px; fuera de ella no cambia ni un píxel (verificado: 14.781 px cambiados, 0 fuera). El código de LaMa es Apache-2.0.
Qué falla todavía
- Visera cerrada en escenas oscuras. En escenas con poca luz o a la luz de una vela, varias imágenes salen con el casco cerrado tapando la cara, incluso con el último punto. Gana el "caballero" genérico del modelo sobre el personaje. Por eso nuestros prompts piden "visera abierta, cara visible". No lo contamos de forma sistemática.
- Interiores y noche en gris. Los fondos pasan del blanco limpio del dataset a fondos recargados y grises, con adornos sueltos.
- Elección a ojo. Elegir el paso 1000 es una valoración sobre 16 pares semilla-prompt, no una métrica.
- La zona reparada, algo más granulada. A mucho zoom, la zona reparada de la armadura se ve ligeramente más granulada que lo que la rodea.
- Dos hojas de pruebas sin revisar (4 y 6) de las 8.
- Para la v2 añadiríamos medio cuerpo, risa, escenas sentadas e interiores al dataset.
Qué recibe un cliente
El mismo montaje con tus dibujos en lugar de los nuestros. Un grafo de ComfyUI para generar el personaje; un script que descarga cada modelo desde su fuente oficial y comprueba su hash; y la licencia de cada modelo, listada para que la revises. Funciona en local, con Docker; la versión para GPU alquilada forma parte de la entrega.
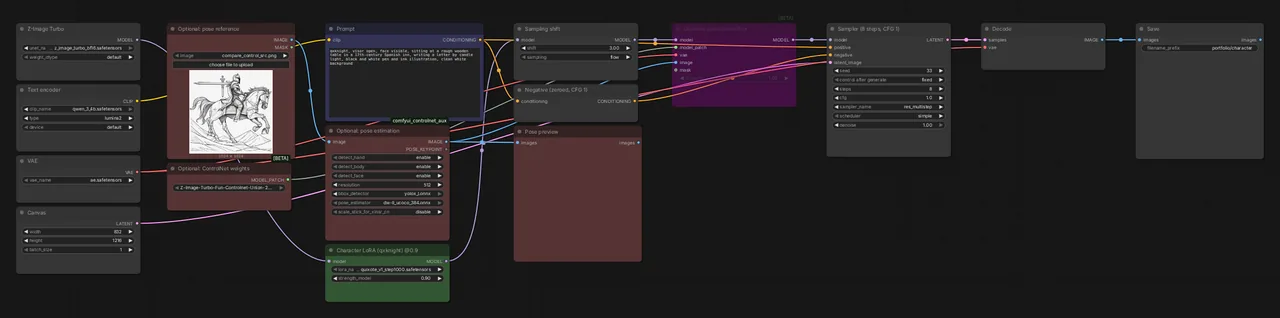
La licencia de cada modelo va listada para que la revises. Hay componentes que dejamos fuera a propósito por su licencia (por ejemplo, ciertos preprocesadores y reescaladores de uso no comercial). No garantizamos derechos de autor sobre las imágenes generadas con IA; depende de cada país.
Esto lo hacemos para equipos
Sección comercial. Grawwww vende el trabajo que describe este artículo.
Un personaje o un estilo propio, coherente en todo tu libro, juego o marca. Nos envías tus dibujos o tu ficha de personaje. Montamos el sistema con tu estilo, te enseñamos escenas nuevas y te entregamos el montaje para que lo ejecutes tú. Un ingeniero senior revisa y responde de cada entrega.
Modelos a medida, desde 450 € sin IVA. Es precio de partida: la propuesta cierra alcance y precio tras el diagnóstico (300 € sin IVA, que se descuenta si seguimos).
Envíanos tu caso: https://grawwww.xyz/equipos/
Todas las imágenes de este artículo están generadas con IA; salvo la comparativa de modelos base, con nuestro propio LoRA.
Otro artículo: Los agentes no se revisan solos →